Domain argw.de kaufen?
Wir ziehen mit dem Projekt
argw.de um.
Sind Sie am Kauf der Domain
argw.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain argw.de kaufen?
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
Ähnliche Suchbegriffe für Verbmobil-Foundations-of-Speech-to-Speech
Top-Angebote
Produkte zum Begriff Verbmobil-Foundations-of-Speech-to-Speech:
-
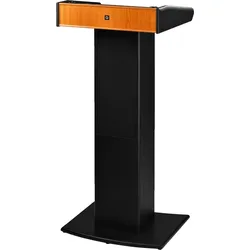
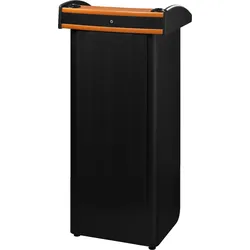
SPEECH-104DSPEECH-104D, Eine innovative Qualitätslösung für die hochwertige Sprach- und Musikbeschallung: Das SPEECH-104D-Aktiv-Rednerpult von MONACOR verbindet Klangqualität, Lautstärkefähigkeit und Komfort in einer perfekten Weise. Akkubetrieben und damit komplett ortsunabhängig macht allein das SPEECH-104D aus jeder zu beschallenden Fläche ein Auditorium. Es passt sich aber selbstverständlich auch in jede gegebene Umgebung ein, wo eine zeitlich begrenzte oder auch permanente Redestelle benötigt wird. Die integrierte Verstärker- und Lautsprechertechnik erlaubt dabei nicht nur die Sprachwiedergabe, sondern macht auch Musik und zum Beispiel Film- und Präsentationsvertonungen denkbar gut und einfach. Ein Schwanenhalsmikrofon einstecken und/oder eine Signalquelle anschließen - einschalten - fertig.1632,01 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Krause, Benjamin: Hate SpeechHate Speech , Strafbarkeit und Strafverfolgung von Hasspostings , Scheinwerfer-Vorschaltgeräte & Zündgeräte > Beleuchtung , Auflage: 1. Auflage, Erscheinungsjahr: 20221021, Produktform: Kartoniert, Autoren: Krause, Benjamin, Auflage: 22001, Auflage/Ausgabe: 1. Auflage, Seitenzahl/Blattzahl: 114, Keyword: Hasskriminalität; Silencing; Radikalisierung, Fachschema: International (Recht)~Internationales Recht~Strafrecht, Fachkategorie: Strafrecht, allgemein, Warengruppe: TB/Strafrecht, Fachkategorie: Internationales Öffentliches Recht: Strafrecht, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: XII, Seitenanzahl: 114, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: C.H. Beck, Verlag: C.H. Beck, Verlag: Verlag C.H. Beck oHG, Länge: 236, Breite: 157, Höhe: 12, Gewicht: 252, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0004, Tendenz: 0, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Lagerartikel, Unterkatalog: Taschenbuch,39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
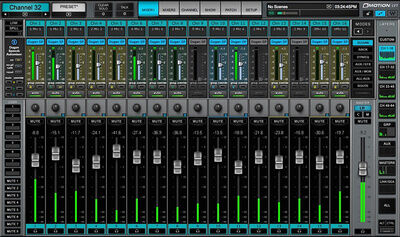
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer599,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
-
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **
Welche guten Text-to-Speech-Seiten kann ich finden?
Es gibt viele gute Text-to-Speech-Seiten, die eine natürliche und hochwertige Sprachausgabe bieten. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly, Microsoft Azure Speech und IBM Watson Text to Speech. Diese Dienste ermöglichen es Benutzern, Text in verschiedenen Sprachen in eine Sprachausgabe umzuwandeln. **
Top-Angebote
Produkte zum Begriff Verbmobil-Foundations-of-Speech-to-Speech:
-
Verbmobil: Foundations of Speech-to-Speech Translation, Fachbücher von Wolfgang Wahlster"Verbmobil: Foundations of Speech-to-Speech Translation" ist ein Fachbuch, das sich mit den Grundlagen der automatischen Spracherkennung und Übersetzung spontaner Sprache beschäftigt. Es wurde im Kontext eines umfangreichen Forschungsprojekts entwickelt, das von der deutschen Bundesregierung initiiert wurde, um die Herausforderungen der Sprachverarbeitung zu bewältigen. Das Buch dokumentiert die interdisziplinäre Zusammenarbeit von bis zu 33 Forschungsgruppen aus verschiedenen Bereichen wie Informatik, Übersetzungswissenschaft und künstlicher Intelligenz. Es beleuchtet die Komplexität spontaner Sprache, einschliesslich Phänomenen wie Mehrdeutigkeiten, Selbstkorrekturen und Unflüssigkeiten. Die Ergebnisse dieser Forschung bieten wertvolle Einblicke in die Entwicklung von Systemen, die in der Lage sind, gesprochene Sprache in Echtzeit zu erkennen und zu übersetzen. Die Arbeit ist sowohl für Fachleute als auch für Studierende von Interesse, die sich mit den Herausforderungen und Fortschritten in der Sprach- und Übersetzungstechnologie auseinandersetzen möchten.160,49 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Speech-to-Speech Translation, Fachbücher von Yutaka Kidawara, Kawai Hisashi, Sumita EiichiroDas Buch "Speech-to-Speech Translation" bietet eine umfassende Analyse der Technologien, die hinter der Sprach-zu-Sprach-Übersetzung stehen. Es beleuchtet sowohl historische als auch zukünftige Perspektiven und erklärt detailliert die Komponenten wie Spracherkennung, Sprachübersetzung und Sprachsynthese. Das System der Sprach-zu-Sprach-Übersetzung (S2S) hat das Potenzial, Sprachbarrieren zu überwinden und die Kommunikation zwischen Menschen weltweit zu erleichtern. Die Entwicklung dieser Technologie begann in Japan im Jahr 1986 und hat sich über die Jahre global verbreitet. Mit der zunehmenden Verfügbarkeit von Smartphones und Tablets wird S2S zunehmend in den Alltag integriert. Das Buch enthält auch einzigartige Kapitel, die die Leistung von S2S-Systemen im Vergleich zur menschlichen Kompetenz bewerten, und bietet Einblicke in die zukünftige Entwicklung, insbesondere im Bereich der simultanen Übersetzung für Vorträge und Nachrichtenübertragungen.53,49 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
SPEECH-104DSPEECH-104D, Eine innovative Qualitätslösung für die hochwertige Sprach- und Musikbeschallung: Das SPEECH-104D-Aktiv-Rednerpult von MONACOR verbindet Klangqualität, Lautstärkefähigkeit und Komfort in einer perfekten Weise. Akkubetrieben und damit komplett ortsunabhängig macht allein das SPEECH-104D aus jeder zu beschallenden Fläche ein Auditorium. Es passt sich aber selbstverständlich auch in jede gegebene Umgebung ein, wo eine zeitlich begrenzte oder auch permanente Redestelle benötigt wird. Die integrierte Verstärker- und Lautsprechertechnik erlaubt dabei nicht nur die Sprachwiedergabe, sondern macht auch Musik und zum Beispiel Film- und Präsentationsvertonungen denkbar gut und einfach. Ein Schwanenhalsmikrofon einstecken und/oder eine Signalquelle anschließen - einschalten - fertig.1632,01 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Krause, Benjamin: Hate SpeechHate Speech , Strafbarkeit und Strafverfolgung von Hasspostings , Scheinwerfer-Vorschaltgeräte & Zündgeräte > Beleuchtung , Auflage: 1. Auflage, Erscheinungsjahr: 20221021, Produktform: Kartoniert, Autoren: Krause, Benjamin, Auflage: 22001, Auflage/Ausgabe: 1. Auflage, Seitenzahl/Blattzahl: 114, Keyword: Hasskriminalität; Silencing; Radikalisierung, Fachschema: International (Recht)~Internationales Recht~Strafrecht, Fachkategorie: Strafrecht, allgemein, Warengruppe: TB/Strafrecht, Fachkategorie: Internationales Öffentliches Recht: Strafrecht, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: XII, Seitenanzahl: 114, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: C.H. Beck, Verlag: C.H. Beck, Verlag: Verlag C.H. Beck oHG, Länge: 236, Breite: 157, Höhe: 12, Gewicht: 252, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0004, Tendenz: 0, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Lagerartikel, Unterkatalog: Taschenbuch,39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
Ähnliche Suchbegriffe für Verbmobil-Foundations-of-Speech-to-Speech
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer599,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Quality of Synthetic Speech, Fachbücher von Florian HinterleitnerDas Buch "Quality of Synthetic Speech" bietet eine umfassende Analyse der Wahrnehmungsqualitätsdimensionen synthetischer Sprache. Es untersucht die Fortschritte in der Forschung und vergleicht diese mit dem aktuellen Stand der Technik. Der Autor, Florian Hinterleitner, identifiziert fünf universelle Dimensionen der Wahrnehmungsqualität für Text-to-Speech (TTS) Signale: Natürlichkeit der Stimme, prosodische Qualität, Flüssigkeit und Verständlichkeit, Abwesenheit von Störungen sowie Ruhe. Darüber hinaus wird ein Testprotokoll vorgestellt, das eine effiziente Identifizierung dieser Dimensionen in Hörtests ermöglicht. Das Buch beleuchtet auch verschiedene Faktoren, die diese Dimensionen beeinflussen, und führt unterschiedliche Techniken zur instrumentellen Qualitätsbewertung von TTS-Signalen ein und testet diese. Abschliessend werden die Anforderungen für die Integration eines instrumentellen Qualitätsmasses in ein concatenatives TTS-System untersucht.128,39 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Practice of Speech, Sachbücher von Byron W. King"Practice of Speech" ist eine bedeutende Sammlung von Redekunst und erfolgreichen Auswahltexten, die in der fünften Auflage unverändert als hochwertiger Nachdruck der Originalausgabe von 1888 veröffentlicht wurde. Dieses Sachbuch, herausgegeben von Hansebooks, widmet sich der Erhaltung historischer Literatur und bietet einen Einblick in die Kunst des Sprechens, die für die Entwicklung kommunikativer Fähigkeiten von grosser Bedeutung ist. Hansebooks hat sich darauf spezialisiert, Werke aus verschiedenen Themenbereichen wie Forschung, Wissenschaft, Reisen, Kochen, Ernährung und Medizin zu veröffentlichen. Durch die Neubearbeitung dieser historischen Texte wird nicht nur das Wissen bewahrt, sondern auch der Zugang zu wertvollen Informationen für zukünftige Generationen ermöglicht. Die Publikation ist ein wertvolles Gut für alle, die sich für die Entwicklung ihrer rhetorischen Fähigkeiten und die Geschichte der Redekunst interessieren.31,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
-
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
-
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **
-
Welche guten Text-to-Speech-Seiten kann ich finden?
Es gibt viele gute Text-to-Speech-Seiten, die eine natürliche und hochwertige Sprachausgabe bieten. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly, Microsoft Azure Speech und IBM Watson Text to Speech. Diese Dienste ermöglichen es Benutzern, Text in verschiedenen Sprachen in eine Sprachausgabe umzuwandeln. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.